
网关高可用从 0 到大厂形态——keepalived、VIP 漂移与 LVS 接入层
负载均衡与高可用 · 第 1 篇(开篇)
下一篇:系列完结(规划中:《keepalived 脑裂与仲裁》《LVS DR 模式与公网接入》)
〇、先说人话:全文就四句话
费曼技巧第一步:假装把这篇文章讲给一个完全没碰过运维的朋友听。全部内容,其实就四句话:
- 网关是全公司流量的大门。只装一扇门,门塌了全公司断网——所以装两扇一模一样的。
- 可客户端只认一个地址,怎么办?给两扇门挂同一块门牌(VIP):同一时刻门牌只钉在一扇门上,塌了自动搬到另一扇。负责搬门牌的软件,叫 keepalived。
- 以后门多到三扇以上、流量扛不住了,就在所有门前再盖一间传达室(LVS):它不拆包裹、只看信封,照一张名单把包裹轮流分下去——又快又便宜。
- 但传达室不是标配:网关不超过 3 台,每台自带一块 keepalived 门牌("同机形态")就是最优解,绝大多数公司到这一步就够了。
后面十节,只是把这四句话一句句展开成能上线的配置。哪天你能不看文章把这四句讲顺,这篇就算学会了。
一、问题:全公司只有一扇门
一句话本质:一台网关就是全公司的单点。单点的意思是——它一个人挂,所有人陪葬。
想象你给公司上了 API 网关,所有前端的 baseURL 都指向它。某天这台机器的内存条坏了:重启、换件、恢复路由,运气不好要折腾一下午。这一下午里挂掉的不是某一个系统,是所有系统。
解法听起来朴素:再买一台,两台干一样的活。但新问题立刻冒出来——
前端到底连哪台的 IP?
连 A,A 挂了照样断;连 B 同理。让前端记两个 IP 自己切换?每个前端都得改代码、每个用户都得刷新页面。工程上对这个问题有统一答案,就是本文第一个主角:VIP(Virtual IP,虚拟 IP)。
二、VIP:一块会搬家的大门牌
先纠正最容易想歪的地方:VIP 一点都不"虚拟",它就是一个普普通通的 IP 地址。它的特殊之处只有一条规矩——同一时刻,全网络只许一台机器的网卡上挂着它。挂在谁家,流量就进谁家。
(网卡:机器上插网线的那块硬件。IP 地址本来就可以理解成钉在网卡上的门牌号,而 VIP 是一块公共的、会搬家的门牌。)
我在实验室起了两台容器当真机:KA1(172.67.0.21)和 KA2(172.67.0.22)。给 KA1 跑上 keepalived 后,看它的网卡:
$ ip -4 addr show eth0
    inet 172.67.0.21/24 brd 172.67.0.255 scope global eth0
    inet 172.67.0.20/24 scope global secondary eth0    ← VIP 钉在这里
同一时刻,KA2 的网卡上没有这个地址:
$ ip -4 addr show eth0        # 在 KA2 上执行
    inet 172.67.0.22/24 brd 172.67.0.255 scope global eth0
    (没有 172.67.0.20 —— 门牌不在它家)
于是两种 IP 的分工清楚了:
| 角色 | 是什么 | 干的活 |
|---|---|---|
| KA1 / KA2 各自的 IP | 工位号 | 管理员 ssh 上去维护用,用户不认识它 |
| VIP(172.67.0.20) | 公共门牌 | 用户和 DNS 只认它;钉在谁家,流量进谁家 |
keepalived 的全部工作,就是决定这块门牌此刻钉在谁家:机器挂了,它把门牌搬到备胎家;修好了,再搬回来。注意它自始至终不碰业务流量,一个字节都不碰——证据放在第四节,先卖个关子。
2.1 下钻一层:Linux 内核里根本没有"虚拟 IP"
把窗户纸捅破:Linux 内核里没有"虚拟 IP"这个概念,也没有任何"VIP 开关"。VIP 能存在,靠的是内核一个最普通的能力——一块网卡可以挂多个 IP 地址。
机制就两层:
- 每块网卡在内核里就是一张地址清单。包到达时内核查清单:目的地址在清单里 → "这封信是寄给我的",收下交给上层;不在 → 该转发的转发,该丢的丢。所谓"VIP 钉在谁家",翻译成内核语言就是"谁的清单里有这条记录"。
- 地址挂上去的同时,内核自动把它登记进一张叫 local 的路由表——本机收件名单。在名单里的地址,内核才认作"我的"。
不装任何软件,root 手工就能当一次 keepalived(以下在 WSL2 Ubuntu 里实测):
$ ip addr add 172.67.0.20/24 dev eth0     # 给网卡挂上本文同款 VIP

$ ip -4 addr show eth0
2: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc mq state UP group default qlen 1000
    inet 172.22.212.111/20 brd 172.22.223.255 scope global eth0
    inet 172.67.0.20/24 scope global eth0   ← 多出一行,没有任何"虚拟"标记
细心的读者会发现:这里没有 KA1 输出里的 secondary 标记。secondary 的含义很朴素——只有和已有主地址同子网的第二个地址才标 secondary(KA1 的 VIP 172.67.0.20/24 与本机 IP 172.67.0.21/24 同网段,所以标了);这台 WSL 的网卡原本在 172.22.x 段,172.67.0.20 对它是另一个子网,于是各自都是主地址。标记而已,待遇一模一样。
再看内核自动登记的收件名单:
$ ip route show table local | grep 172.67.0.20
local 172.67.0.20 dev eth0 proto kernel scope host src 172.67.0.20
broadcast 172.67.0.255 dev eth0 proto kernel scope link src 172.67.0.20
local ... scope host 这行就是"172.67.0.20 是本机地址"的正式登记,ip addr add 自动送的,不用手工登记。验证名单生效:
$ ping -c 2 172.67.0.20
PING 172.67.0.20 (172.67.0.20) 56(84) bytes of data.
64 bytes from 172.67.0.20: icmp_seq=1 ttl=64 time=0.037 ms
64 bytes from 172.67.0.20: icmp_seq=2 ttl=64 time=0.044 ms
0.037 毫秒——包根本没出这台机器:内核在收件名单里查到"这是我的地址",直接在内存里转了一圈还回来。最后摘掉门牌:
$ ip addr del 172.67.0.20/24 dev eth0
$ ip -4 addr show eth0 | grep -c 172.67.0.20
0
结论:VIP 的"挂上/摘下",在内核层面就是 ip addr add / ip addr del 一行命令的事。
2.2 那 keepalived 到底自动化了什么
把手工流程和 keepalived 对齐:
| 手工 | keepalived | 说明 |
|---|---|---|
| 你盯着两台机器,谁挂了手动敲命令 | VRRP 心跳(IP 协议号 112)自动选主 | "谁挂了"不用人盯 |
ip addr add / ip addr del | 内部走 netlink 接口,效果与命令等价 | netlink = 内核提供给程序的"命令行" |
| 手工做不了:挨家挨户通知邻居 | 广播免费 ARP(GARP):"172.67.0.20 的 MAC 是我" | 刷新全网交换机与邻居的 ARP 缓存 |
3.6 节实测的"约 6 秒接管",拆开正是:约 3 秒心跳判死(3 × advert_int)+ 免费 ARP 全网刷新交换机表项的零点几到几秒。keepalived 没有魔法——它是"选主 + 改地址清单 + 喊一嗓子"三件事的自动化套装。
(再往下一层还有戏:LVS 的 DR 模式会把 VIP 挂到 lo 回环设备上并做 ARP 抑制,那是下一篇的主角,按下不表。)
把这两小节拼成一张图:左侧是数据面(流量照着 ARP 缓存找到持牌的 KA1,进 eth0 清单、查 local 名单、交给应用),右侧是待命的 KA2;keepalived 只在控制面干活——底部实线是每秒心跳,顶部虚线是免费 ARP 广播,netlink 是它改写地址清单的那支笔。
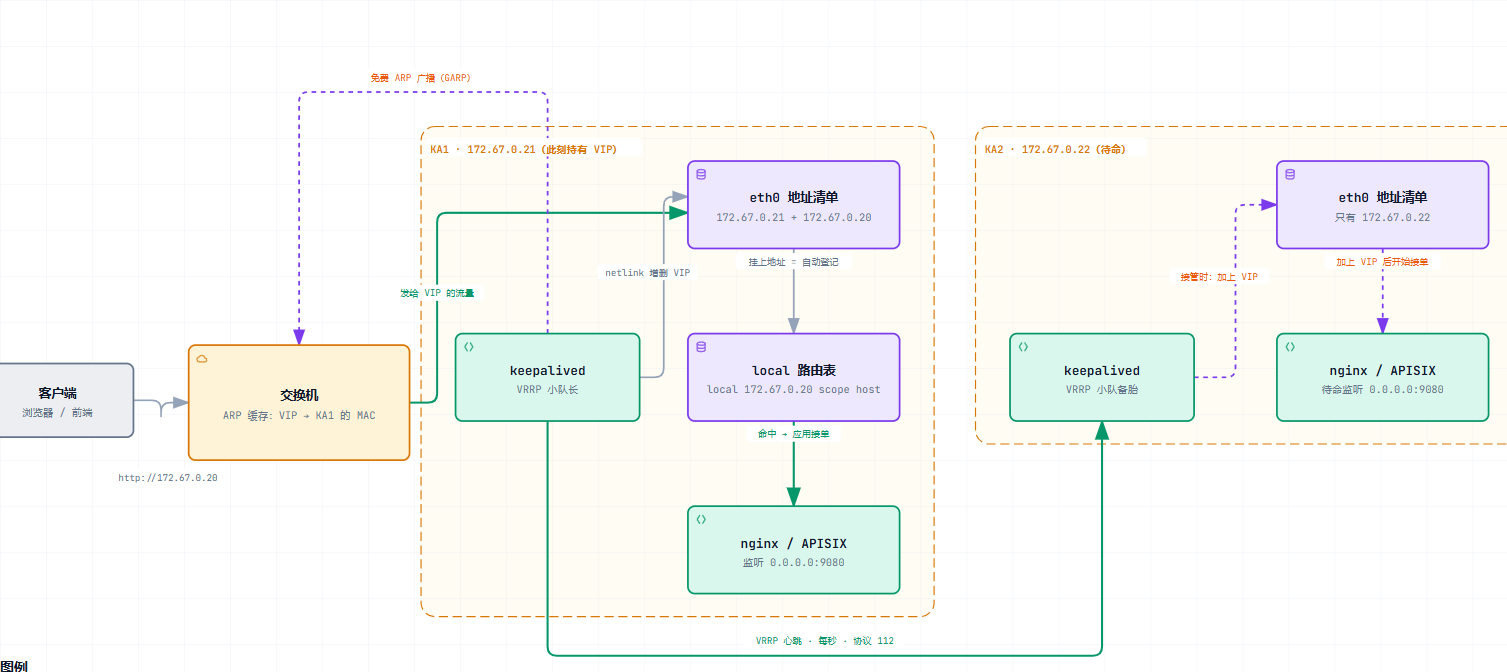
这节收束成一句:VIP 负责"地址不变",keepalived 负责"地址搬家",业务自己负责"接电话"。
三、keepalived 从 0 到上岗:七步实测
以下每条命令都在两台 Ubuntu 22.04 容器上真实跑过,可以照抄复现。
3.1 第 0 步:规划——先填表再动手
| 角色 | 机器 | 机上跑的业务 | priority |
|---|---|---|---|
| KA1 | 172.67.0.21 | nginx(或 APISIX) | 100(大哥) |
| KA2 | 172.67.0.22 | 同样的业务 | 90(备胎) |
| VIP | 172.67.0.20 | —— 用户只连这个 | —— |
三条铁律:两台必须同一网段(心跳靠二层广播,可以理解成两台机器得在同一个村子里互相喊得应);virtual_router_id 两台必须一致(小队编号);priority 谁大谁持有 VIP。
3.2 第 1 步:装软件(两台都执行)
apt-get update && apt-get install -y keepalived nginx装完会自建空的 /etc/keepalived/ 目录,服务起不来属正常——配置还没写。
3.3 第 2 步:写配置(两台只差两行)
KA1 的 /etc/keepalived/keepalived.conf,逐行翻译成人话:
vrrp_instance VI_1 {              # 一组"抢IP小队",名字随便取
    state MASTER                  # 初始角色(KA2 上写 BACKUP)     ← 差异①
    interface eth0                # 心跳和VIP绑在哪块网卡
    virtual_router_id 61          # 小队编号 0~255,两台必须相同
    priority 100                  # 权位,谁大谁持有VIP(KA2 写 90) ← 差异②
    advert_int 1                  # 心跳间隔1秒
    virtual_ipaddress {
        172.67.0.20/24            # 大家争夺的VIP
    }
}
名词随手解释:VRRP(虚拟路由冗余协议)一句话版本——几台机器定期互相喊"我还在"(喊话就是心跳),谁权位高谁持有公共 IP;vrrp_instance 就是一支这样的小队,advert_int 是喊话间隔。
网卡名别猜,用 ip route | awk '/default/ {print $5}' 查真实名字(可能是 ens192、enp0s3)。KA2 的配置就是把 MASTER 改 BACKUP、100 改 90,其余逐字节一致。
三个容易想歪的点(想歪了就不算学会):
state只是开机初始站位,真正说了算的是priority——就算 KA1 写着state MASTER但 priority 只有 50,KA2(BACKUP/90)照样把它摁下去virtual_router_id和 VIP 两台必须一致,差一个字符就是两支互不认账的小队,各抢各的- 以后任何改动(心跳间隔、换 VIP)都要两台同步改,只许 state/priority 各自维护
3.4 第 3 步:启动(两台)
systemctl enable --now keepalived
systemctl status keepalived       # active (running)
3.5 第 4 步:验收
验收就两条:门牌在 KA1 家、curl VIP 是 KA1 应答。
ip addr show eth0 | grep 172.67.0.20   # KA1 上能看到 = 对;KA2 上没有 = 对
curl http://172.67.0.20/                # 应答内容 = KA1 的页面
我给两台各放了一个自我介绍页面,此刻访问 VIP:
$ curl http://172.67.0.20/
我是 KA1 (MASTER 172.67.0.21)
3.6 第 5 步:故障演练——上岗前必做
三幕剧,输出全部真实。
第一幕,正常状态:VIP 在 KA1 网卡上,curl VIP 是 KA1 应答(见上文)。
第二幕,KA1 猝死——kill 掉它的 keepalived:
$ docker exec ka1 pkill keepalived
  第1秒: KA2 网卡上 VIP 已出现 ✓
$ curl http://172.67.0.20/
我是 KA2 (BACKUP 172.67.0.22)
注意一个细节:KA1 上的 nginx 还活着,但门牌已经不在它家——没有流量再找它了。"机器活着但没生意",正是 VIP 机制和"重启机器"的本质区别。
第三幕,KA1 修好复活:
$ systemctl start keepalived        # KA1 上执行
$ ip addr show eth0 | grep 172.67.0.20
    inet 172.67.0.20/24 scope global secondary eth0
$ curl http://172.67.0.20/
我是 KA1 (MASTER 172.67.0.21)       ← priority 100 > 90,大哥回归抢回门牌
看全程内幕的最佳位置是 journalctl -u keepalived -f,两台都开着,能实时看到"心跳丢失 → 接管"和"大哥回归 → 让位"的日志对白。
"几秒接管"这笔账要算得清:BACKUP 连续 3 个心跳没收到才判定对方死亡(3 × advert_int ≈ 3 秒),加上免费 ARP 广播刷新全网交换机的地址表(ARP:地址解析协议,全网共用的"IP 对应哪块网卡"登记表,门牌搬了家要全网重新登记),整容器拔网线实测约 6 秒,真机断电场景按 3~4 秒预期——用户浏览器会自动重试,基本无感。
3.7 第 6 步:聪明让位(track_script,强烈建议加)
上面的配置只防"机器死了"。还有一种更阴险的情况:机器活得好好的,但网关进程死了——门牌不会动,流量继续打进一台"活着的死机器"。加一段体检解决:
global_defs {
    enable_script_security        # 配了体检脚本就必须开这两行, 否则 keepalived 拒绝启动
    script_user root
}

vrrp_script chk_nginx {
    script "/usr/bin/curl -s -o /dev/null http://127.0.0.1/"   # 探活本机业务
    interval 3       # 每3秒查一次
    weight -30       # 查不通→priority减30(100变70,低于90,自动让位)
    fall 2           # 连续失败2次才算真死(防网络抖动误杀)
    rise 2           # 连续成功2次才算复活(防反复横跳)
}

vrrp_instance VI_1 {
    state MASTER                   # KA2: BACKUP
    interface eth0
    virtual_router_id 61
    priority 100                   # KA2: 90
    advert_int 1
    virtual_ipaddress {
        172.67.0.20/24
    }
    track_script { chk_nginx }     # 相对 3.3 的配置, 真正新增的就这一行
}
翻译:给小队加一条家规——本人重病(业务端口探不通),就算机器还活着也得让出门牌。
3.8 第 7 步:上岗
keepalived 只管门牌不碰业务。把业务(nginx / APISIX / 别的什么)在两台都跑起来,前端和 DNS 全部指向 VIP,完事。
四、keepalived 和 APISIX 是怎么配合的
最多人想岔的一步:"keepalived 怎么把数据转给 APISIX?"——它不转,一个字节都不转。它俩之间没有 API、没有调用、没有对话。两个证据。
证据一,看谁在监听端口。在网关机上:
$ ss -tlnp | grep 9080
LISTEN 0 511 0.0.0.0:9080 0.0.0.0:*  users:(("openresty",pid=1,fd=20))  ← APISIX 的内核
(keepalived 不在任何 TCP 端口上——它的心跳是 IP 协议号 112,根本不走 TCP/UDP 端口)

$ ps aux | grep keepalived
root  3853  0.0  0.0  27832  2544 ?  Ss  Sep16  0:00 keepalived -D -f /etc/keepalived/keepalived.conf   ← 活着,但不接客
root  3854  0.0  0.0  27832  3184 ?  S   Sep16  0:16 keepalived -D -f /etc/keepalived/keepalived.conf      (父子两个进程: 主进程管心跳, 子进程管体检)
证据二,让两台网关的流水账(access log)说话。网关集群正常时打一发请求,账记在持 VIP 的 M1 头上:
172.66.0.1 - - [16/Sep/2026:12:43:46 +0000] 172.66.0.100:9080 "GET /hello HTTP/1.1" 200 30 0.001 "-" "curl/7.81.0" 172.66.0.51:80 200 0.001 "http://172.66.0.100:9080" "bfab6dec94b658bacede7f37c8aad5ba"停掉 M1 的 keepalived、等 VIP 漂到 M2,再打一发:
172.66.0.1 - - [16/Sep/2026:12:43:52 +0000] 172.66.0.100:9080 "GET /hello HTTP/1.1" 200 30 0.001 "-" "curl/7.81.0" 172.66.0.51:80 200 0.001 "http://172.66.0.100:9080" "75b5e812ef179f96c869913f6c74f7a8"
(这条出现在 M2 的日志里——同一时刻 M1 的日志没有新增)
复活 M1,等门牌搬回来再打:
172.66.0.1 - - [16/Sep/2026:12:45:34 +0000] 172.66.0.100:9080 "GET /hello HTTP/1.1" 200 30 0.001 "-" "curl/7.81.0" 172.66.0.51:80 200 0.001 "http://172.66.0.100:9080" "0ac140cfa78e437cae56dce7ab201df3"
(这条回到 M1 的日志里)
结论一句话:请求打到 VIP,永远是"此刻网卡上挂着 VIP 的那台机器"里的网关接单记账。数据是照着门牌自己找上门的,不是谁转交给 APISIX 的。
那"配合"靠什么?靠一份三方契约,三方互相不说话:
| 契约条款 | 谁负责 | 违约后果 |
|---|---|---|
① 网关必须监听 0.0.0.0,不能写死自己 IP | 网关的配置文件 | 写死 192.168.1.31 → VIP 漂过来也没人接电话,经典翻车点 |
| ② 两台网关认识完全相同的路由 | etcd 同步 | 路由不一致 → 漂移瞬间"换了一家公司",部分接口 404 |
| ③ 机器活着但网关死了也要让位 | keepalived 的 track_script | 不配 → 半死机状态,VIP 不漂,流量黑洞 |
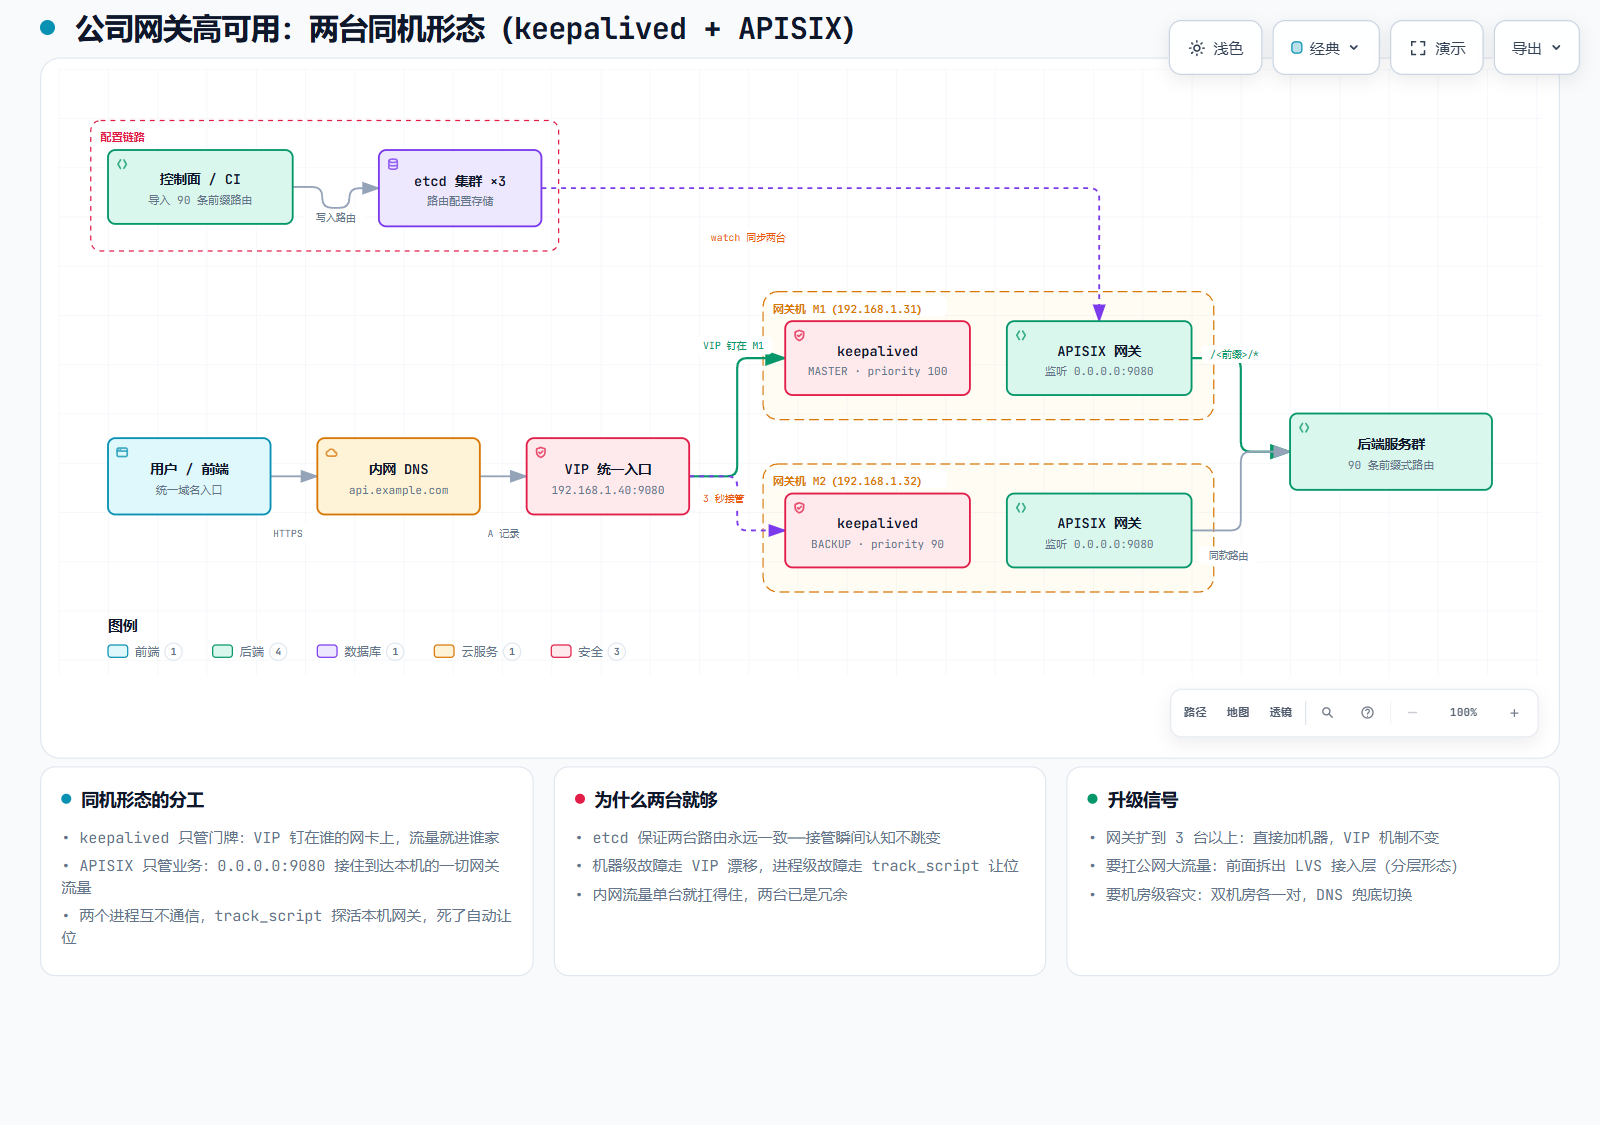
看图注意一件事:keepalived 和 APISIX 两个进程之间没有任何通信。这正是这个架构简洁的地方——把 APISIX 换成 nginx 或任何别的网关,keepalived 的配置一个字都不用改。
五、四层与七层:看信封 vs 拆信读信
这一节一句话:四层设备只看信封,七层设备才拆开读信纸。
把一个请求想象成一封信:
┌─────────────────────────────────────────┐
│ 信封:                                    │
│   收件地址 192.168.1.40(IP)             │
│   收件窗口 9080 端口                      │  ← 四层设备只读到这里
│ ───────────────────────────────────────  │
│ 信纸(HTTP 内容):                        │
│   "GET /usercenter/api/list HTTP/1.1"    │  ← 七层设备才会拆开读
│   Header: Authorization: xxx             │
│   Body: {"page": 2}                      │
└─────────────────────────────────────────┘- 四层 = 传输层:看信封(IP + 端口),不拆信
- 七层 = 应用层:拆信读内容,知道你要干嘛(查哪个路径、带什么登录态)
("层"指 OSI 网络模型——一封信从寄出到送达要过七道工序,第四道管"送到哪个端口",第七道管"信里到底写了什么"。模型记不住没关系,记住"看信封的便宜、拆信的贵"就够了。)
两种设备的分工与身价:
| 四层设备(LVS) | 七层设备(APISIX/nginx) | |
|---|---|---|
| 能做的事 | 只能按 IP:端口 分 | 按路径/Header/Cookie/Body 做任何事 |
| 抗量 | 百万级连接 | 数万~数十万 QPS |
| 代价 | 极便宜:不拆包,只记一张转发表 | 贵:每个请求完整解析一遍 HTTP |
四层为什么扛得住百万连接?它对每封信只做"扫条码 → 换单转发",开销几乎恒定;七层每封都要"拆封、通读、决策、重封",天然贵一个量级。所以大厂的经典分工是:便宜的四层扛量,昂贵的七层干精活。
顺带把身边的设备归个类:keepalived 的 VIP 连四层都不算(只管 IP,端口都不看);Windows portproxy、云 SLB 的"四层监听"是四层;nginx 的 location + proxy_pass、APISIX 的 uris: /usercenter/*、云 SLB 的"七层监听"是七层。
六、LVS:传达室里的自动分拣机
6.1 它是什么
LVS(Linux Virtual Server)不是一个装出来的软件,是 Linux 内核自带的转发引擎,内核里那个模块叫 IPVS。modprobe ip_vs 给它插上电;ipvsadm 只是一支笔,往它肚子里那张表格填数据。它快的唯一原因:转发在内核里完成。(内核:操作系统最里层、直接管硬件的那一层;普通程序跑在"用户态",数据包要递到程序手里得绕一大圈——LVS 省掉了这一圈。)
用传达室的比方:所有包裹进大楼必经传达室(内核),LVS 就是传达室里装的自动分拣机——包裹到传达室就被机器改写收件人直接转走,根本不用递给任何程序处理。
6.2 配置 = 在纸条上写三行字
实测(WSL 内核加载 ip_vs 后):
modprobe ip_vs                                # 插电源
ipvsadm -A -t 172.66.0.200:9081 -s rr        # 纸条第一行: 到这个VIP:端口的包,按"轮流"分
ipvsadm -a -t 172.66.0.200:9081 -r 172.66.0.11:9080 -m   # 名单①: 网关1
ipvsadm -a -t 172.66.0.200:9081 -r 172.66.0.12:9080 -m # 名单②: 网关2(-m 是 NAT 模式:分拣时顺手改写信封上的收件人,并做端口翻译 9081→9080。)
看这张内核里的纸条:
$ ipvsadm -Ln
Prot LocalAddress:Port Scheduler
  -> RemoteAddress:Port           Forward Weight ActiveConn InActConn
TCP  172.66.0.200:9081 rr
  -> 172.66.0.11:9080             Masq    1      0          3
  -> 172.66.0.12:9080             Masq    1      0          3
算法(怎么分)除了 rr(轮询:一人一发),还有 wrr(加权轮询:好机器多分)、lc(最少连接:谁手头闲给谁)、sh(源 IP 哈希:同一个客人永远去同一个窗口,即会话保持)。记住 rr 和 wrr 够应付九成场景。
6.3 实测一:轮询分流
打 6 发的命令就是一条循环——-o /dev/null 丢掉页面内容,-w "%{http_code} " 只打状态码,6 发一行看完(6.4 节的 000 也是它打出来的);--noproxy '*' 让 curl 直连、别被环境里的 HTTP 代理劫走:
for i in $(seq 6); do curl -s --noproxy '*' -o /dev/null -w "%{http_code} " http://172.66.0.200:9081/hello; done; echo连打 6 发请求,看内核自己的账本:
$ ipvsadm -Ln --stats
  -> 172.66.0.11:9080        3 conns    1218 bytes
  -> 172.66.0.12:9080        3 conns    1218 bytes
6 发一边 3 发,分毫不差。这就是"四层分流"的全部真相——只改信封上的收件人,不拆信不看内容。
6.4 实测二:裸 LVS 的翻车现场
停掉名单上的一台后端(模拟网关宕机),再打 3 发:
再打3发: 000 200 000 ← 000 = 超时,一半请求寄给了死人裸 LVS 不做健康检查——名单上还写着死人的名字,它照样轮流寄。所以生产上 LVS 从不裸奔,由 keepalived 全权打理(见 6.6)。
这一幕是理解整个架构的钥匙:分拣机聪明在快,蠢在不管死活;管死活的活儿,交给别人。
6.5 实测三:扩容 = 名单加一行字
名单里加入第三台网关,再打 6 发:
$ ipvsadm -a -t 172.66.0.200:9081 -r 172.66.0.34:9080 -m
(打 6 发后)
  -> 172.66.0.11:9080    累计连接 +2
  -> 172.66.0.12:9080    累计连接 +2
  -> 172.66.0.34:9080    累计连接 +2     ← 新机器立刻开始接活
再玩个花的:把算法换成 wrr、给第三台权重 4(好机器多干活),连打 10 发,增量正好 2 : 2 : 6——权重一行字,比例立刻变。
LVS 里的全部配置就五样:VIP:端口(收件地址)、算法(怎么分)、模式(怎么改包)、后端名单(分给谁,必须认识每一台网关)、每台权重。它不知道路径、域名、路由规则、健康状态——故意这么蠢,蠢 = 快。聪明事全在别人那儿:路径归网关,健康归 keepalived。
6.6 keepalived + LVS:本来就是一套
keepalived 的另一半工作,就是替 LVS 管这张纸条(这也解释了为什么架构图里它俩总画在同一个框里):
vrrp_instance VI_1 {
    state MASTER                   # 前半身: 心跳 + VIP 漂移(另一台: BACKUP / 90)
    interface ens192
    virtual_router_id 51
    priority 100
    advert_int 1
    virtual_ipaddress {
        192.168.1.40/24            # 与下方 virtual_server 用同一个 VIP
    }
}

virtual_server 192.168.1.40 9080 { # 后半身: 替 LVS 管转发表
    delay_loop 3                   #   每3秒给名单全员做一次体检
    lb_algo wrr                    #   加权轮询
    lb_kind NAT
    protocol TCP                   #   不写这行, keepalived 默认按 UDP 处理, TCP 服务直接配错
    real_server 192.168.1.31 9080 {  #   名单第1行
        weight 1
        TCP_CHECK {                #   体检: 尝试TCP连接
            connect_port 9080
            connect_timeout 2
            retry 2
            delay_before_retry 1
        }                          #   不通→自动摘除; 复活→自动写回
    }
    real_server 192.168.1.32 9080 {  #   名单第2行, 结构同上
        weight 1
        TCP_CHECK {
            connect_port 9080
            connect_timeout 2
            retry 2
            delay_before_retry 1
        }
    }
}
keepalived 一肩挑三件事:VIP 漂移(机器级故障)、LVS 转发表(怎么分流)、后端健康检查(进程级故障自动摘除)。扩容 = 照抄一段 real_server 改 IP,两台 keepalived.conf 同步改,reload 生效,30 秒的活。
七、完整 keepalived.conf:四大块与三处差异
一份完整模板(已通过 keepalived -t 语法校验,退出码 0)。先记住四大块各自的一句话职责,再看就不晕:
global_defs:署名与安全底线vrrp_script:体检项目vrrp_instance:门牌小队(keepalived 的前半身)virtual_server:LVS 名单(后半身,不用 LVS 就整段删)
# ---------- 全局定义 ----------
global_defs {
    router_id GW_M1                # 本机署名(日志用), 另一台写 GW_M2
    enable_script_security         # 体检脚本只许root执行(防篡改后自动提权)
    script_user root
}

# ---------- 体检项目 ----------
vrrp_script chk_apisix {
    script "/usr/bin/curl -s -o /dev/null http://127.0.0.1:9080/"
    interval 3
    timeout 2
    weight -30
    fall 2
    rise 2
}

# ---------- VIP 小队 ----------
vrrp_instance VI_APISIX {
    state MASTER                   # ★M2改: BACKUP
    interface ens192               # ip route 查真实网卡名
    virtual_router_id 51           # 两台一致, 同网段全网唯一
    priority 100                   # ★M2改: 90
    advert_int 1
    # nopreempt                    # 可选: 大哥修好不抢回, 防二次抖动(只能用在BACKUP侧)
    # unicast_src_ip 192.168.1.31  # 可选: 交换机禁组播时改单播, 两台互换
    # unicast_peer { 192.168.1.32 }
    authentication {
        auth_type PASS
        auth_pass Ap1six           # 前8位有效, 两台一致
    }
    virtual_ipaddress {
        192.168.1.40/24            # 争夺的VIP, 前端/DNS只填这个
    }
    track_script { chk_apisix }
}

# ---------- LVS 名单(选配, 不玩LVS整段删) ----------
virtual_server 192.168.1.40 9080 {
    delay_loop 3
    lb_algo wrr
    lb_kind NAT
    protocol TCP
    real_server 192.168.1.31 9080 {
        weight 1
        TCP_CHECK { connect_port 9080  connect_timeout 2  retry 2  delay_before_retry 1 }
    }
    real_server 192.168.1.32 9080 {
        weight 1
        TCP_CHECK { connect_port 9080  connect_timeout 2  retry 2  delay_before_retry 1 }
    }
}
模板里注释掉的 nopreempt 单独说透。keepalived 默认是"抢位模式"(preempt):priority 100 的大哥修好重启那一刻,立刻把 VIP 抢回来——3.6 节第三幕演的就是这个。抢位有代价:门牌搬家 = VIP 漂移 + 免费 ARP 全网刷新,全网有几秒抖动窗口;而刚修好的机器往往还没热身(缓存是冷的、连接池是空的),立刻接全量流量,可能引发第二次故障。
nopreempt 把"抢位"改成"让位到底":大哥修好后不抢,继续让现在的持牌者干活,自己安静当备胎,直到对方也倒下才接管。两条配套铁律:
nopreempt只能写在state BACKUP的机器上——state MASTER的实例配它,keepalived 直接拒绝启动。理由也直白:MASTER 的定义就是"开机必抢",再配"不抢"自相矛盾。- 所以想全局不抢,两台都得写
state BACKUP:开机第一轮没人持牌,仍按 priority 定初始归属(100 那台先拿到),之后谁修好都不抢。
代价也想清楚:修好的大哥长期闲着,流量一直压在备胎上,"哪台在干活"和"哪台是大哥"不再对齐——认门牌只能靠 ip addr,不能靠记忆。两台内网网关的常规场景,默认抢位就够;只有"大哥修好立刻抢回"确实引发过二次故障的机器,才值得换 nopreempt。
两台机器的差异背下来就三处:router_id、state、priority(若启用单播再加 src/peer 互换)。其余逐字节相同。
改完自查一条:keepalived -t -f /etc/keepalived/keepalived.conf——只测语法不运行,生产改配置的保命习惯。
八、公司两台 vs 大厂分层:该用哪种形态
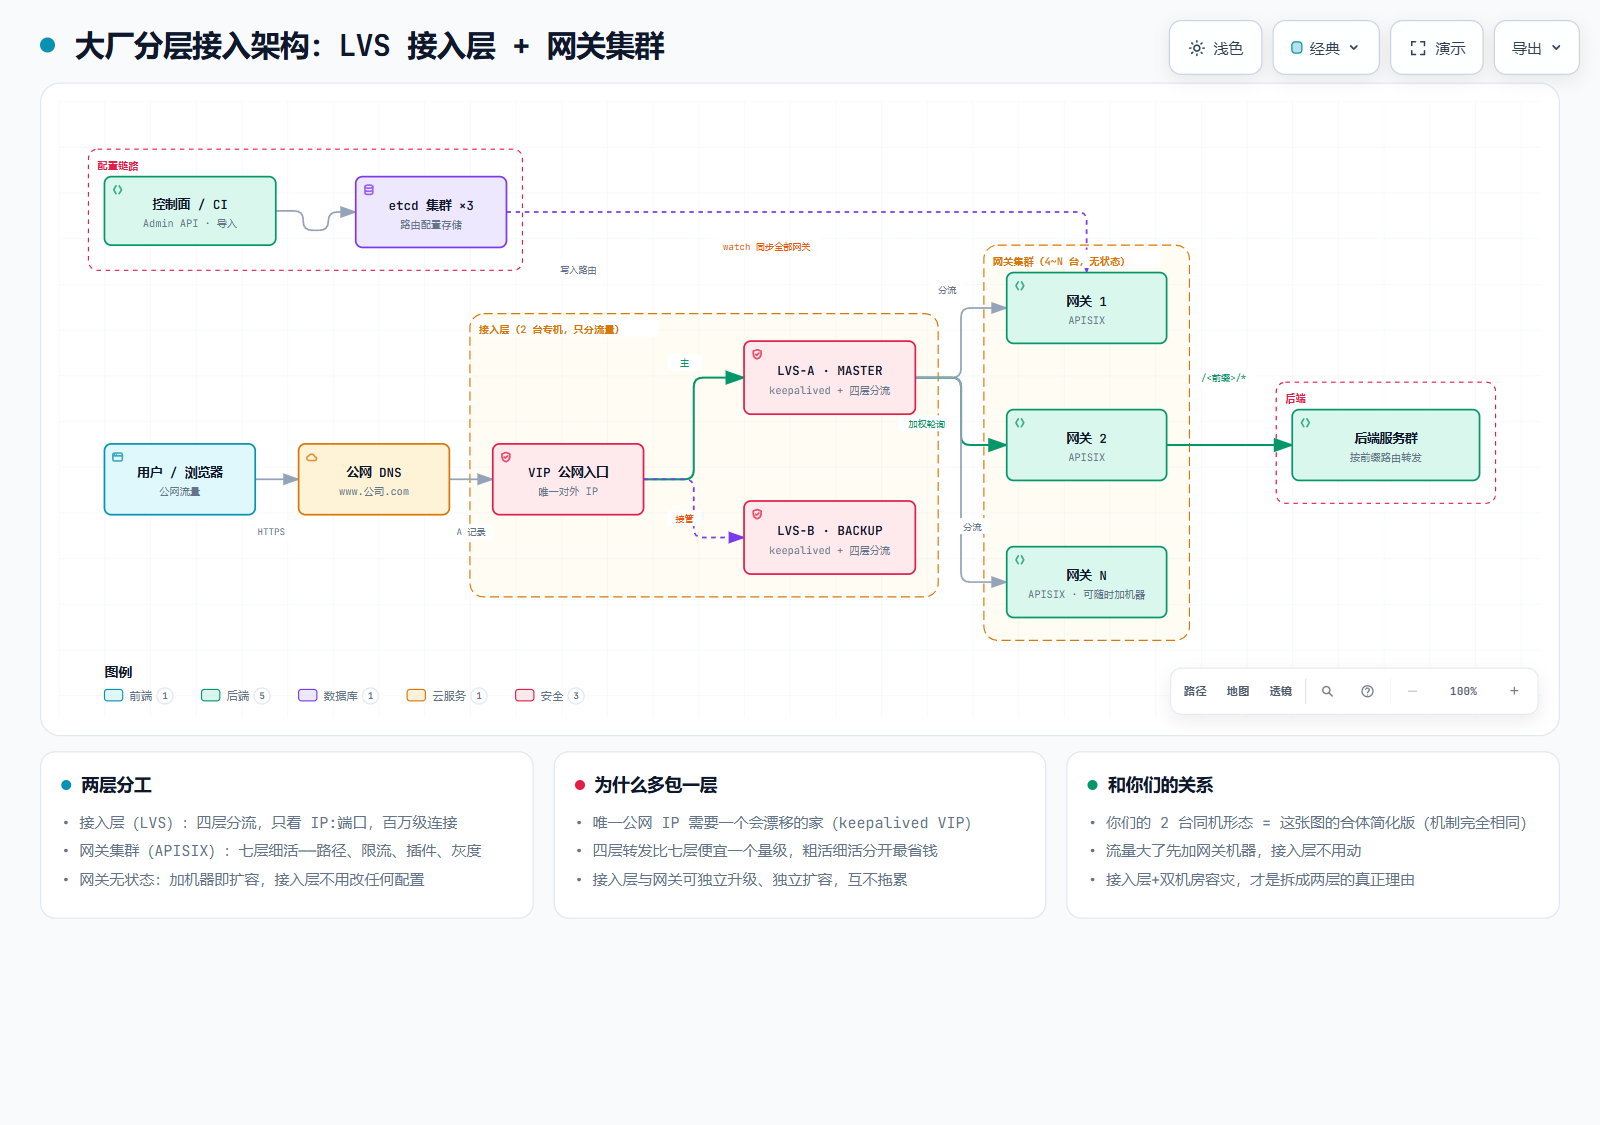
先说人话:机器少就挤在一起,机器多、流量大才分层。两种形态用的都是这篇文章讲过的同一套零件。
| 同机形态(两台) | 分层形态(大厂) | |
|---|---|---|
| 机器数 | 2 台 | 2 台专机 LVS + 4~N 台网关 |
| 每台机器上跑什么 | keepalived + APISIX | LVS 机:keepalived + LVS;网关机:纯 APISIX |
| 分流在哪层做 | APISIX 的 upstream 自带轮询 | LVS 四层分流(百万级连接) |
| 适合谁 | 绝大多数中小公司、内网网关 | 公网大流量、网关超过 3 台 |
| 拆层的信号 | —— | 网关要独立扩缩容;四层扛量七层干精活要分开算钱 |
分层形态的精髓是两层各干各的粗细活:LVS 只看 IP:端口(四层,便宜,扛量),网关集群拆信干细活(七层,贵,精活);网关无状态(配置全在 etcd,watch 实时同步到每一台),加机器即扩容,LVS 名单添一行完事。
而两层防挂的手法你已经全会了:接入层自身就是一对 keepalived 主备 + VIP 漂移,和两台网关之间玩的是同一个把戏。如果主备两台同时挂呢?——双机房各一套接入层,DNS 把域名切到另一机房兜底(分钟级);再往上才是异地多活。工程上不存在"永不挂的东西",追求的是"挂了用户感觉不到":消灭单点 + 恢复自动化,两条而已。
公司两台网关的裁剪建议:删掉 virtual_server 整段(APISIX 的 upstream 自带轮询,不需要 LVS),剩下的就是"keepalived 只管门牌 + 网关死也让位"的最小可靠形态——本文第四节那张图。
九、生产部署检查表
容器里遇不到、真机上必查的几件事,逐条打勾再上岗:
十、FAQ 与踩坑实录
Q1:两台都显示 MASTER、IP 时通时断?
脑裂(split-brain)典型症状:心跳不通但两台都活着,各抢各的 VIP。先查防火墙 112 和交换机组播,再考虑配双心跳路径。内网双机场景概率极低,但症状要认得。
Q2:curl VIP 返回 000 是什么意思?
超时无应答。本文 6.4 节的实测:后端死了但 LVS 名单没摘除,一半请求寄给死人。带上 keepalived 的健康检查(或任何带探活的负载均衡)就不会发生。
Q3:为什么是 3~4 秒接管,不是 0 秒?
接管时间 = 判死时间 + 搬门牌时间,两段都能算出来。
判死时间有精确公式(VRRP 协议规定):判死时间 = 3 × advert_int + (256 − priority) / 256。代入 KA2(priority 90):3 × 1 + 166/256 ≈ 3.65 秒。公式的两半各有用意:
- 3 × advert_int:BACKUP 要连丢 3 拍心跳才判 MASTER 死,不是丢 1 拍就判。网络偶发丢包太常见(网卡忙、交换机抖一下),一丢就切等于天天误切;连丢 3 拍,基本只有真死机做得到。
- (256 − priority) / 256:权位越低,额外多等一小会(KA2 约 0.65 秒)。如果还有第三台 priority 95 的备胎,它 0.24 秒后就到点、先到先接管;KA2 晚 0.65 秒才到点,到点前收到别人的心跳就继续待命——多台备胎不会同时发难、来回抢门牌。
搬门牌时间(零点几到几秒):netlink 把 VIP 挂上网卡是毫秒级,大头是免费 ARP 刷新——交换机的 MAC 表、邻居主机的 ARP 缓存要各自认下"VIP 换 MAC 了",不同设备节奏不同,典型零点几秒、慢的几秒。3.6 节"拔网线实测约 6 秒"里超出 3.65 秒的部分,就是这一段。
想更快?把 advert_int 从 1 调到 0.5,判死变 1.5 + 0.65 ≈ 2.15 秒。但代价翻倍地来:心跳包数量 ×2;判死窗口变窄,网络一抖就容易凑满 3 丢 → 误切换变多;而每次切换本身就带一次 GARP 全网抖动。省 1.5 秒、换来更多次抖,通常不划算——所以 1 秒是甜点位:几秒内接管,用户的浏览器自动重试基本把缝隙盖住。
Q4:VIP 漂回 MASTER 后,前几秒请求还是旧机器应答?
正常现象:交换机 ARP 缓存还没刷新。用户侧浏览器自动重试可吸收;介意的话用 nopreempt 让大哥修好后安静当备胎,不抢回("不抢回"到底什么意思、为什么只能配在 BACKUP 侧,展开在第七节模板后面那段)。
Q5:keepalived 到底占不占端口?
不占任何 TCP/UDP 端口。心跳走 IP 协议号 112。ss -tlnp 里永远找不到它——找不到才说明它健康。
Q6:为什么我的 LVS 实验不生效,流量全去了同一台?
检查宿主机有没有别的 DNAT 抢先。笔者的实测翻车:网关容器发布过 -p 9080:9080,docker 的 DNAT 规则把宿主机上所有目的端口 9080 的包直接劫走,LVS 根本没轮到出手。换个没被占用的端口(如 9081,LVS 顺手做端口翻译)立刻正常。
十一、费曼自检:合上文章,你能答出几条
学没学会的唯一检验标准:讲给别人听。不看文章回答下面七条,卡壳的那条,就是回去重读的那节:
- 为什么不能让前端"记住两个 IP 自己切换"?(第一节)
- VIP 和普通 IP 差在哪?keepalived 转不转发业务流量?(第二、四节)
- 两台机器的 keepalived.conf 一共差几处?各是什么?(第三、七节)
- 机器没死、网关进程死了,流量为什么会黑洞?怎么治?(3.7 节)
- 四层和七层设备各自"看信的哪一部分"?为什么四层便宜扛量?(第五节)
- 裸 LVS 为什么会把请求寄给死人?keepalived 怎么补上这个洞?(第六节)
- 公司两台网关的形态里,哪一段配置可以直接删掉?为什么?(第八节)
七条全能脱口而出,这篇就可以翻篇了。
参考资料
- keepalived 官方文档与 man page:
man keepalived.conf(配置项最全的一手来源) - Linux Virtual Server 项目:https://www.linuxvirtualserver.org
- IPVS 内核文档:内核源码
Documentation/networking/ipvs.rst - Julia Evans 的技术写作方式(比喻 + 小实验):https://jvns.ca
- Brendan Gregg 的证据纪律(结论必须配真实输出):https://www.brendangregg.com
- Google SRE Book(演练与故障排查方法论):https://sre.google/books/
➡️ 下一篇:系列完结(规划中:《keepalived 脑裂与仲裁》《LVS DR 模式与公网接入》)